
 1
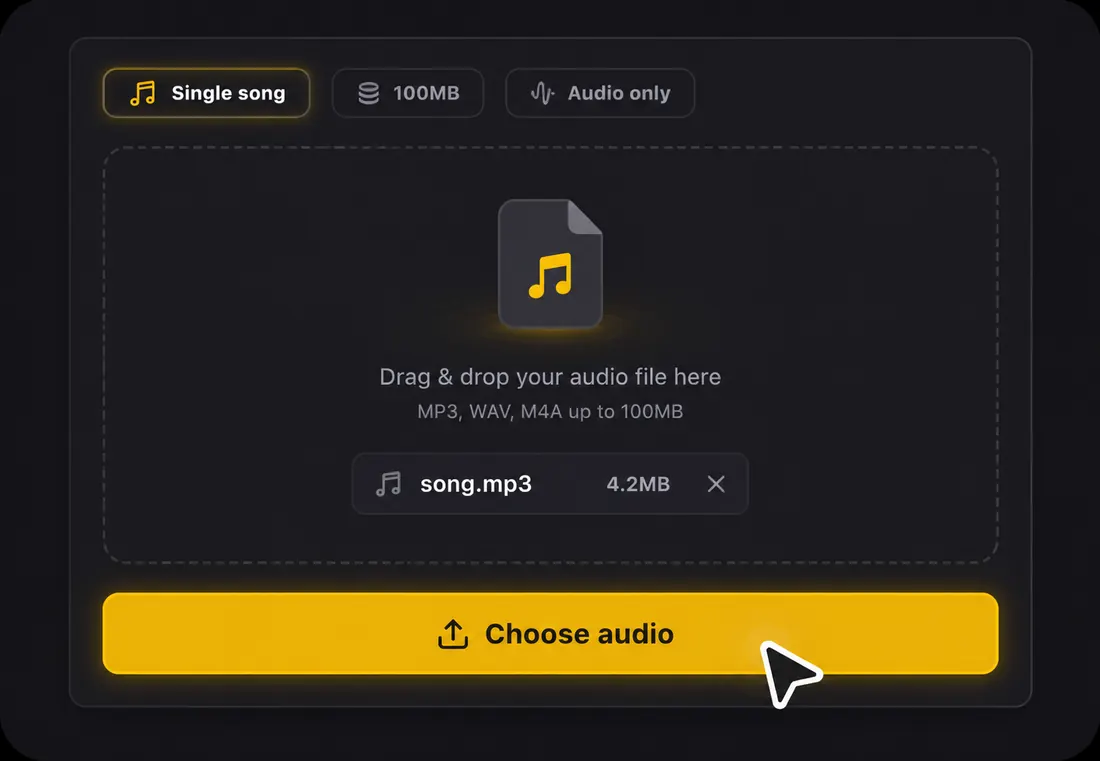
Step 1: 上传歌曲
拖入 MP3、WAV、FLAC、AAC、OGG 或 M4A 音频文件(最大 100MB)。免费注册即送积分,也不需要手动输入歌词。项目从歌词和时间开始,所以 AI 画面会服务于文字,而不是占满整个屏幕。
两者都可以做 AI 音乐视觉;关键差异是:可读、同步的歌词是不是结果中心。
| Detail | LyricVideoMaker | Neural Frames |
|---|---|---|
| 主要重点 | 以可读歌词为核心,AI 画面服务于文字层 | AI 音乐视觉和生成式视频方向 |
| 歌词 | AI 从音频转写歌词,并保持歌词在屏幕上可读 | 更适合作为视觉为主的音乐视频工具来考虑 |
| 时间 | 歌词逐行同步节拍,导出前可检查 | 音乐驱动的画面不一定解决逐行歌词可读性 |
| Neural Frames 更适合 | 粉丝需要读歌词、跟唱时,用 LyricVideoMaker 更直接 | 主要目标是生成式音乐画面时,Neural Frames 更适合 |
做歌词内容时,歌词必须仍然是产品。LyricVideoMaker 让 AI 画面服务于歌词层。
免费试用 LyricVideoMaker1拖入 MP3、WAV、FLAC、AAC、OGG 或 M4A 音频文件(最大 100MB)。免费注册即送积分,也不需要手动输入歌词。项目从歌词和时间开始,所以 AI 画面会服务于文字,而不是占满整个屏幕。
 2
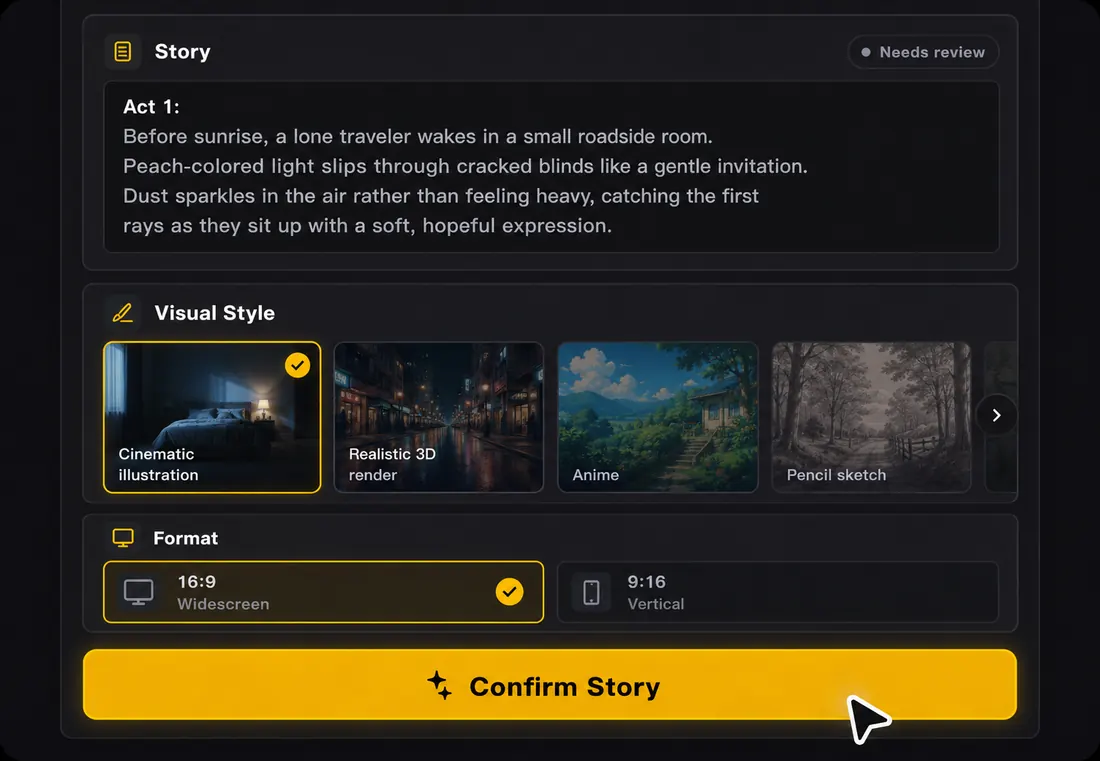
AI 自动从音频转写歌词,并逐行同步到节拍 — 支持 50 多种语言。点击任意歌词行即可编辑。AI 生成匹配歌曲情绪的画面,同时保持歌词可读。
 3
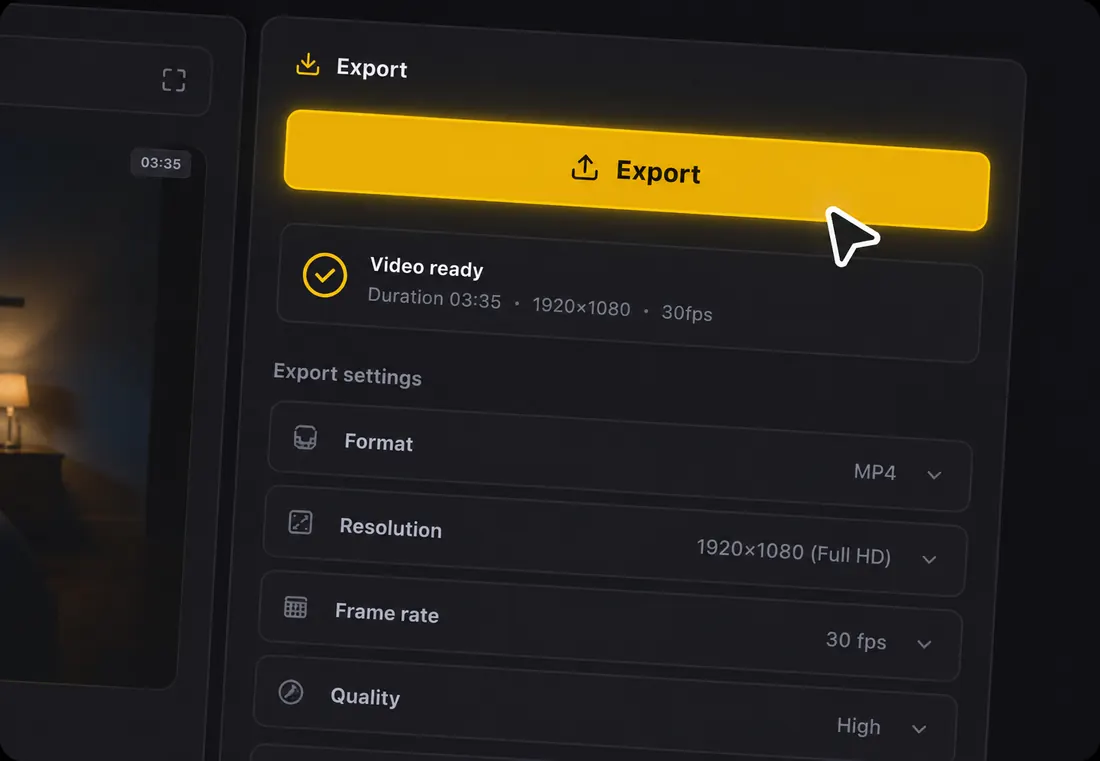
发布前先看完整预览。确认歌词准确可读,然后导出 16:9 适配 YouTube,9:16 适配 TikTok、Reels 和 Shorts,1:1 适配信息流。免费导出带水印版本,无需订阅。
AI 画面生成很有吸引力,但歌词视频有一个不能丢的核心:文字必须清楚、同步。LyricVideoMaker 生成情绪驱动的画面,同时让歌词始终在屏幕中心。
Neural Frames 给你画面。LyricVideoMaker 给你画面和歌词 — 转写、同步、可读、可导出。你不需要选择。
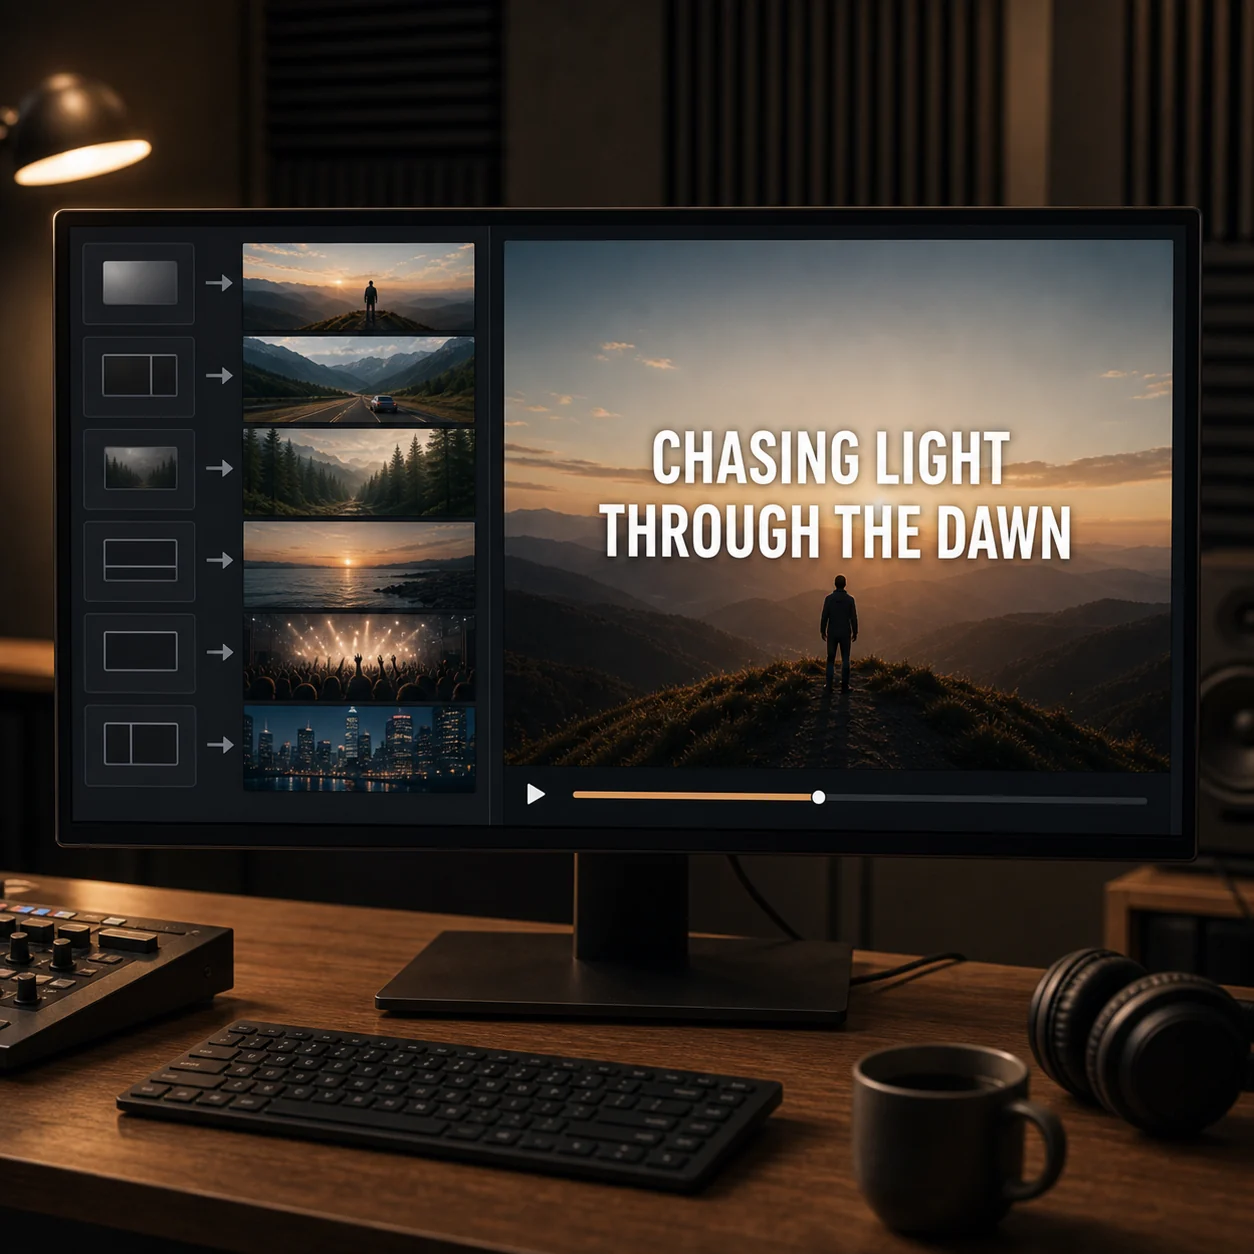
生成画面服务于歌词层,而不是和歌词抢注意力,粉丝能读清他们想看的那一句。
视觉仍然响应歌曲情绪和能量,但它围绕歌词可读性来生成,而不是只追求画面冲击。
歌词优先的可重复流程,让频道和音乐人能持续发布有画面的歌曲,同时不丢掉核心文字层。
Neural Frames 替代工具如果用于歌词视频,核心是让 AI 视觉服务清晰、同步的歌词。Neural Frames 更偏生成式音乐视觉;LyricVideoMaker 从人声开始,转写歌词、同步节拍、生成辅助场景,并导出以歌词为主的 MP4。
输入
只接受音频上传:MP3、WAV、FLAC、AAC、OGG、M4A,单个文件最大 100MB。
歌词
AI 从人声自动转写,支持 50 多种语言自动识别,导出前每一行都能修改。
同步
按节拍和演唱节奏做逐行时间轴,不是把字幕粗暴贴到固定位置。
画面
先做分镜规划,再生成匹配歌曲情绪的 AI 场景图,歌词始终是主角。
导出
保留原始音频导出 MP4,支持 16:9、9:16、1:1,适配 YouTube、Shorts、TikTok、Reels 和信息流。
开始
免费积分起步,可以先跑完整预览,再决定要不要继续投入这首歌。
两个工具都可以属于 AI 音乐工作流。关键是先决定观众主要要看生成画面,还是要读清歌词。
| 判断点 | 实用建议 |
|---|---|
| 视觉优先级 | Neural 类流程强调不断变化的画面;歌词视频流程让文字居中。 |
| 时间优先级 | 歌词工具必须把每行对到人声和节拍,而不只是响应音频能量。 |
| 场景密度 | 复杂场景可以很美,但要给文字留下对比和空间。 |
| 角色一致性 | 生成场景里角色完全连续很难;歌词视频更适合保持情绪一致。 |
| Neural Frames 更适合 | 不需要屏幕文字的抽象或电影感 AI 音乐视觉。 |
| LyricVideoMaker 更适合 | 文字清晰可读,AI 场景在歌词背后服务氛围。 |
渲染前可以按这些点检查,尤其是同一个项目要导出多个平台画幅时。
Neural Frames 替代工具在使用 AI 生成视觉的同时保持歌词清晰可读。真正重要的判断发生在渲染之前 —— 下面是值得记住的几条原则。
纯 AI 视频生成器追求视觉奇观。但歌词视频里文字第一 —— 生成画面应该烘托情绪,而不是和文字抢注意力。
歌词是观众跟着走的主线,不是最后才贴的字幕。顺序永远是先转写、再对节拍对轴、再设计画面。
AI 负责转写、对时间、生成场景;风格对不对、断句改不改、要不要竖屏方屏导出,仍由你判断。
观众不该在「读词」和「看画面」之间二选一。对比度要强、行要短、动效要克制,让画面帮歌词而不是抢戏。
第一遍看文字抓转写错误,第二遍听节奏抓提前或滞后的行,第三遍看平台适配,确保手机信息流里也读得清。
一个项目同时产出 16:9 完整版、9:16 竖屏和 1:1 方形,不用重打歌词、不用重做时间轴,多平台保持一致。
歌还在耳朵里时就做歌词视频:更快听出别扭断句、更早发现听错的词,也更容易判断哪里该加视觉能量。
导出前做一次快速复查,很多质量问题还没变成返工就能处理掉。
| 检查项 | 怎么确认 |
|---|---|
| 音频准备 | 支持 MP3、WAV、FLAC、AAC、OGG、M4A,文件保持在 100MB 以内。 |
| 语言检查 | 系统能自动识别 50 多种语言,但双语 hook 和专名仍建议人工看一遍。 |
| 时间检查 | 节拍同步会给出稳定基础;如果某句比人声早或晚,要手动微调。 |
| 画面检查 | AI 场景图要匹配情绪,同时不能让歌词变难读。 |
| 画幅检查 | 16:9、9:16、1:1 要分别看,因为每种画幅的可读字号都不同。 |
Neural Frames 能做的画面效果都有,再加上真正可读的歌词 — 转写、同步、可导出。
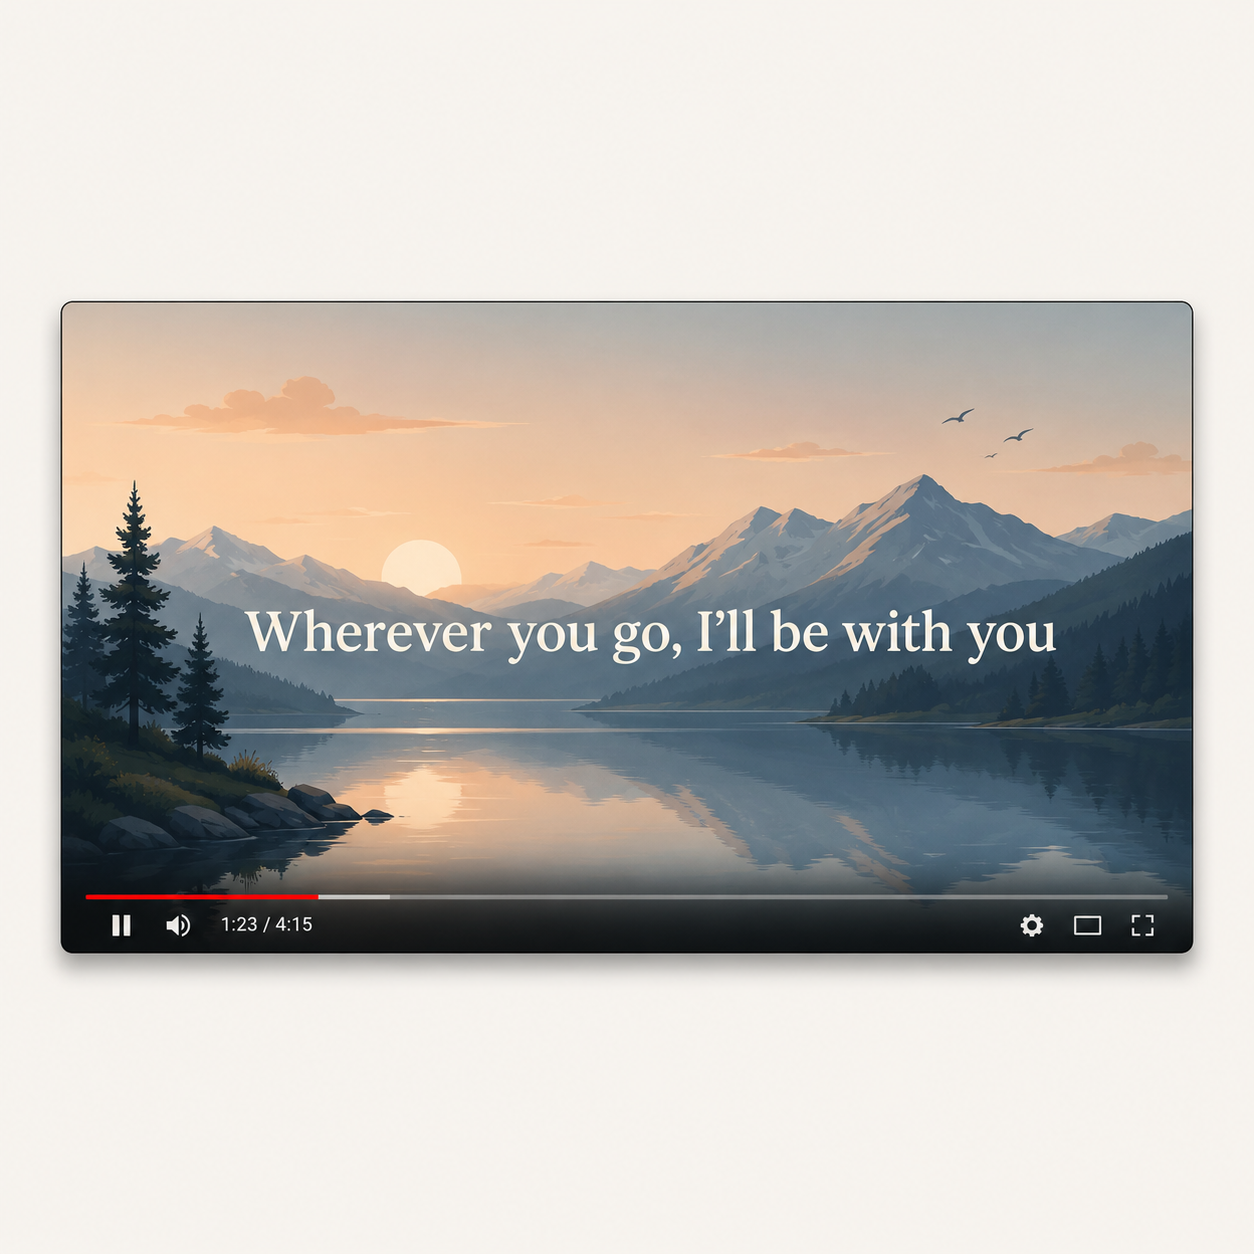
将整首歌导出为 16:9 歌词视频,带 AI 画面和可读歌词。
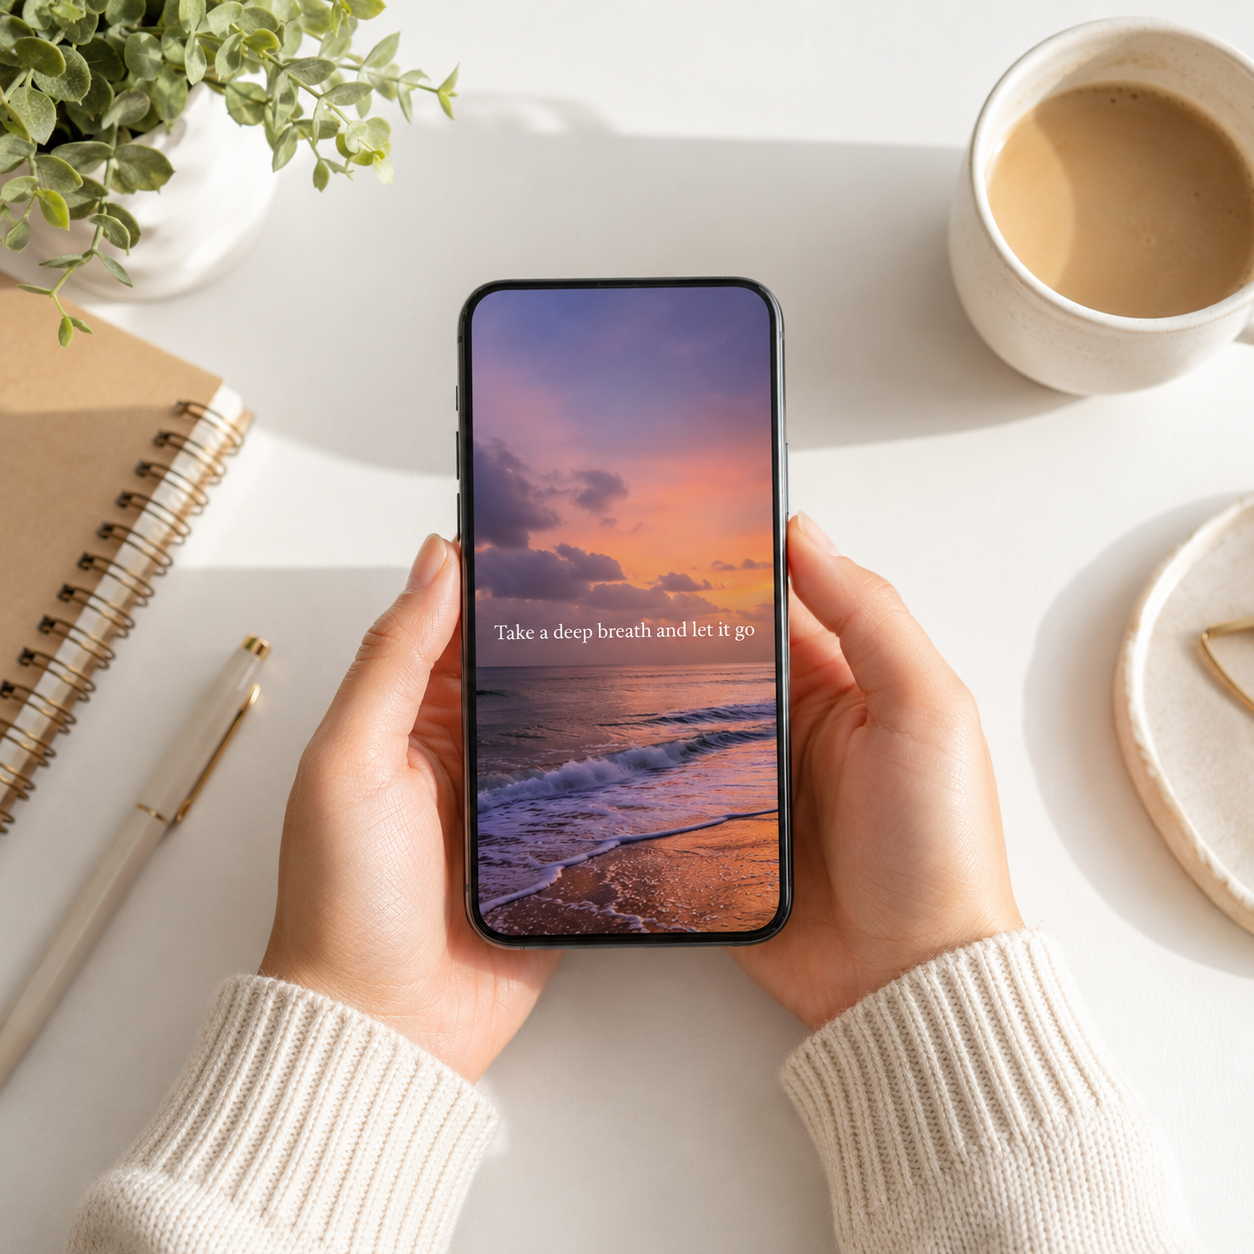
把副歌或 hook 剪成带情绪匹配画面的 9:16 竖屏歌词视频。
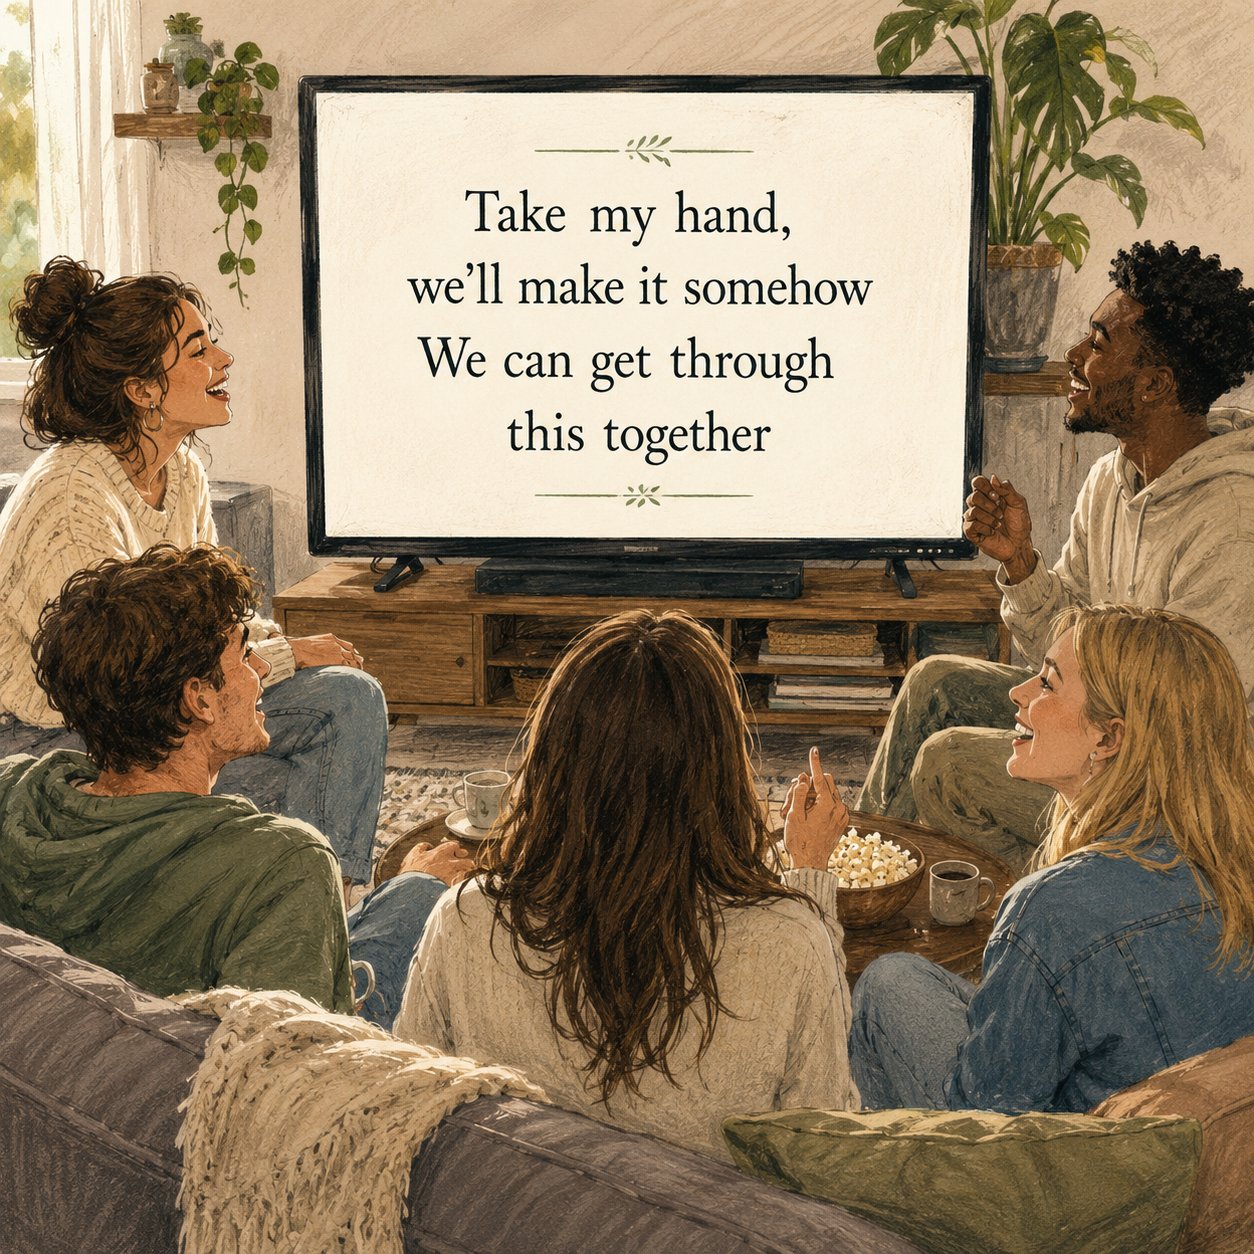
当粉丝需要学歌词,而不只是看漂亮画面时 — LyricVideoMaker 让歌词始终在屏幕中心。
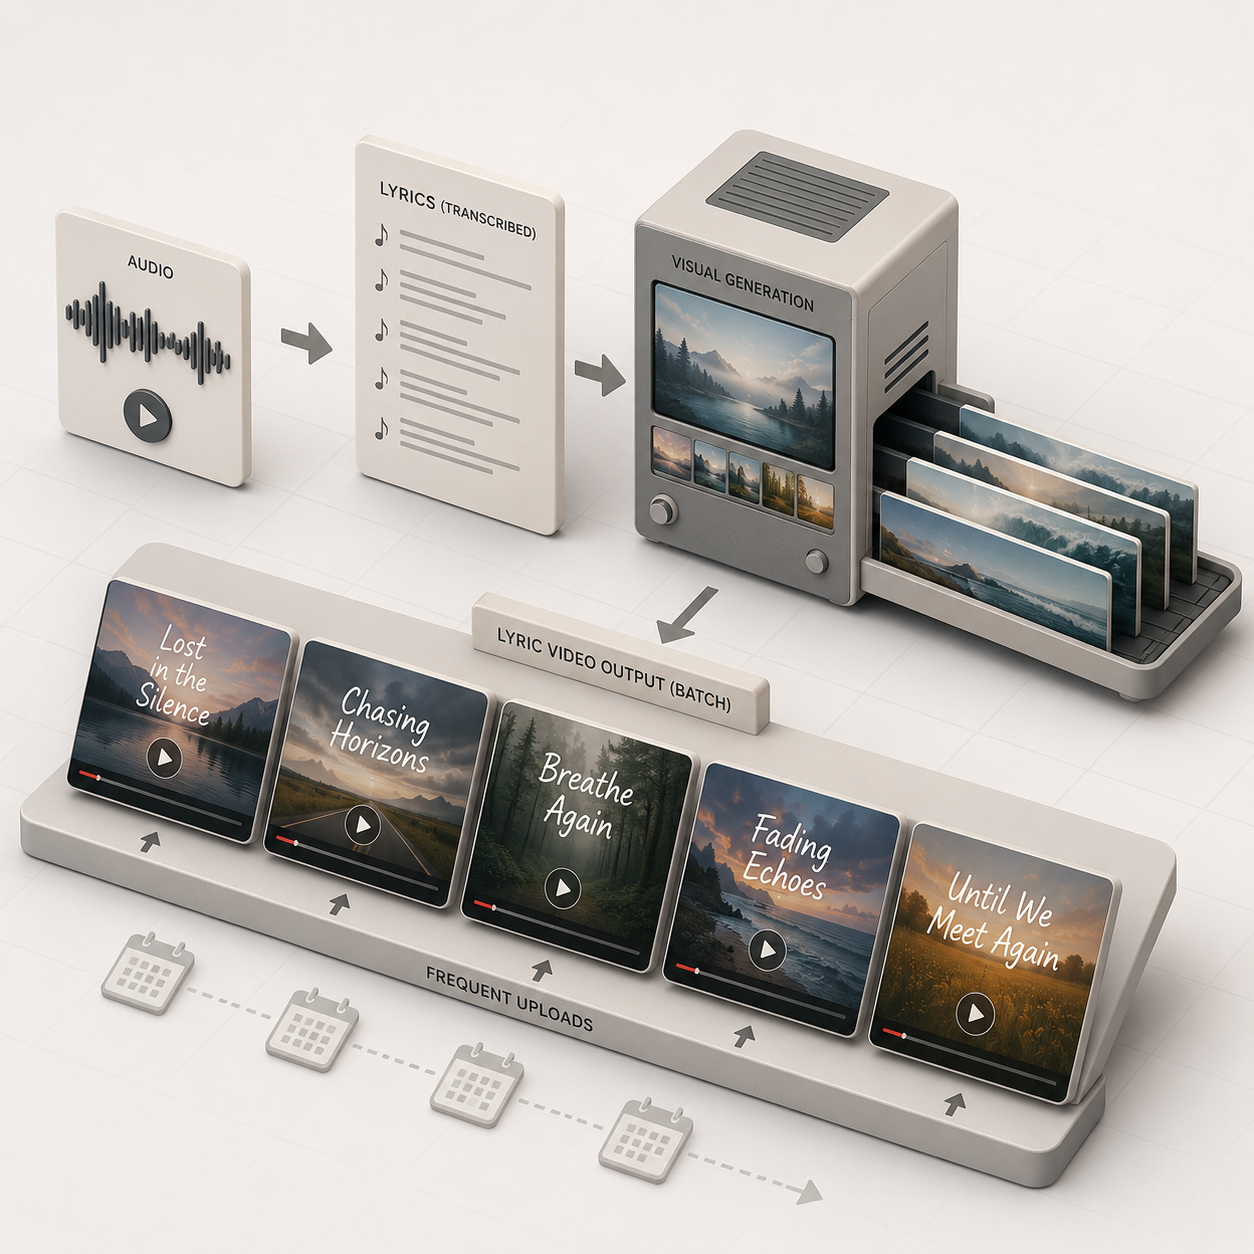
用自动转写和画面生成的可重复流程 — 做歌词内容比 Neural Frames 更快。